SXM — GPU на собственной плате-модуле, которая ставится на системную плату сервера и соединяется с соседними картами быстрой шиной NVLink. PCIe — та же линейка в виде обычной карты расширения. NVL у H100 и H200 — PCIe-версия, которую соединяют мостами NVLink. HGX — плата NVIDIA на 4 или 8 GPU SXM, из которой производители собирают серверы, а DGX — готовый сервер самой NVIDIA. Для обучения на нескольких GPU берите SXM; для инференса и дообучения на одной-двух картах обычно хватает PCIe и NVL.
Содержание11 разделов
Буквы после названия GPU говорят, как чип поставлен в сервер и как он общается с соседними картами. От этого зависят скорость обучения на нескольких GPU, мощность и цена сервера. Здесь — что эти буквы значат на практике и как проверить, какую версию вы получите при заказе.
Откуда столько букв
GPU — это чип. Форм-фактор — то, как этот чип вместе с памятью и питанием оформлен и подключён к серверу. NVIDIA выпускает одну и ту же архитектуру в нескольких форм-факторах: например, H100 бывает SXM и NVL (H100 PCIe 80 ГБ — предыдущая версия), H200 — SXM и NVL, A100 — SXM и PCIe. Чип один, но память, допустимая мощность и связь с соседними картами отличаются.
HGX и DGX описывают следующий уровень сборки: плату на 4 или 8 GPU и готовый сервер. Ещё выше — стойки вроде GB300 NVL72, где GPU десятками объединены в один NVLink-домен.
SXM: модуль для обучения на нескольких GPU
SXM — это GPU на плате-модуле без привычного разъёма PCIe. Модуль ставится прямо на системную плату сервера, а соседние модули связаны NVLink через коммутаторы NVSwitch. Такая схема даёт две вещи.
Быстрая связь между картами. У H100 SXM и H200 SXM — NVLink 900 ГБ/с на GPU, у B200 и B300 — 1,8 ТБ/с. Для сравнения: PCIe Gen5 у тех же H100 и H200 — 128 ГБ/с. При обучении модели на восьми GPU карты постоянно обмениваются градиентами и частями модели, и медленная шина становится узким местом.
Больше мощности. H100 SXM и H200 SXM рассчитаны на мощность до 700 Вт, PCIe-версии — 350–400 Вт у H100 NVL и до 600 Вт у H200 NVL.
Обратная сторона: SXM не вставить в обычный сервер. Модуль работает только на специальной плате, чаще всего HGX, и продаётся в составе сервера на 4 или 8 GPU.
PCIe: карта в обычный слот
PCIe-версия — это привычная карта расширения: её ставят в слот PCIe любого подходящего сервера. Плюсы понятны: серверов под PCIe больше, сборка проще, можно взять одну-две карты вместо целой платы на восемь.
Минус — связь между картами. Без мостов GPU общаются через шину PCIe и процессор. У A100 PCIe есть мост NVLink на две карты (600 ГБ/с), но объединить так восемь карт в одну быструю сеть нельзя.
Для задач, где каждая карта работает сама по себе, это неважно: инференс модели, которая помещается в одну GPU, рендеринг, дообучение LoRA на одной карте. Для обучения большой модели на восьми GPU — важно.
NVL: PCIe-версии H100 и H200 с мостами NVLink
NVL у H100 и H200 — это PCIe-версия, рассчитанная на мосты NVLink.
- H100 NVL — 94 ГБ HBM3, 3,9 ТБ/с, NVLink 600 ГБ/с, мощность 350–400 Вт.
- H200 NVL — 141 ГБ HBM3e, 4,8 ТБ/с, мосты NVLink на 2 или 4 карты — 900 ГБ/с на GPU, мощность до 600 Вт.
У H100 NVL памяти больше, чем у H100 SXM (94 ГБ против 80 ГБ), и она быстрее. Зато связь между картами медленнее и объединяются они небольшими группами через мосты, а не все восемь через NVSwitch. Для инференса крупной модели на одной-двух картах H100 NVL бывает удобнее SXM; для обучения на восьми — нет. Какие версии есть у конкретных моделей, видно на страницах аренда H200 и аренда H100.
H100 и H200 в версиях SXM и NVL: сравнение
| H100 SXM | H100 NVL | H200 SXM | H200 NVL | |
|---|---|---|---|---|
| Форм-фактор | SXM | PCIe, 2 слота, воздушное охлаждение | SXM | PCIe, 2 слота, воздушное охлаждение |
| Память | 80 ГБ HBM3 | 94 ГБ HBM3 | 141 ГБ HBM3e | 141 ГБ HBM3e |
| Скорость памяти | 3,35 ТБ/с | 3,9 ТБ/с | 4,8 ТБ/с | 4,8 ТБ/с |
| Связь между GPU | NVLink 900 ГБ/с | NVLink 600 ГБ/с | NVLink 900 ГБ/с | мост NVLink на 2 или 4 GPU, 900 ГБ/с |
| PCIe | Gen5, 128 ГБ/с | Gen5, 128 ГБ/с | Gen5, 128 ГБ/с | Gen5, 128 ГБ/с |
| Мощность | до 700 Вт | 350–400 Вт | до 700 Вт | до 600 Вт |
| FP8, тензорные ядра (с разреженностью) | 3 958 TFLOPS | 3 341 TFLOPS | 3 958 TFLOPS | 3 341 TFLOPS |
Пришлём 2–3 варианта с форм-фактором, числом GPU и ценой. Ответим за 15 минут в рабочее время.
Оставить заявкуЧто такое NVIDIA HGX: HGX B200 и HGX B300
HGX — платформа NVIDIA: плата на 4 или 8 GPU SXM с NVLink и коммутаторами NVSwitch. Её покупают производители серверов и ставят в свои корпуса со своими процессорами, памятью и сетью. Когда в описании сервера написано «8 × H200 SXM», почти всегда внутри HGX H200. Текущие поколения Blackwell — на 8 GPU:
- HGX B200 — 8 GPU Blackwell SXM, NVLink 1,8 ТБ/с между GPU, 1,4 ТБ памяти на плату;
- HGX B300 — 8 GPU Blackwell Ultra SXM, те же 1,8 ТБ/с, 2,1 ТБ памяти на плату.
DGX H100, DGX H200 и DGX B300: готовый сервер NVIDIA
DGX — сервер, который собирает сама NVIDIA на той же основе, со своими процессорами, сетью и программным стеком. DGX H100 — 8 × H100 и 640 ГБ памяти GPU, DGX H200 — 8 × H200 и 1 128 ГБ; оба потребляют до 10,2 кВт. DGX B300 — 8 × Blackwell Ultra, 2,1 ТБ памяти GPU, около 14 кВт, корпус 10U.
Для того, кто арендует, разница между DGX и сервером партнёра на HGX небольшая: GPU, NVLink и NVSwitch одинаковые. Отличаются процессоры, объём оперативной памяти, диски и сетевые карты для связи между серверами. Это и стоит спросить у поставщика.
NVL72 в одном абзаце
GB200 NVL72 и GB300 NVL72 — стойки, в которых 72 GPU и 36 процессоров Grace связаны NVLink в один домен; у GB300 NVL72 общая пропускная способность NVLink — 130 ТБ/с, память GPU — 20 ТБ. Это уровень обучения моделей на сотни миллиардов параметров и выше. Полное обучение моделей примерно до 50B помещается в сервер на 8 × H200; модель 70B потребует сервера на 8 × B300 или нескольких серверов. Для дообучения LoRA и инференса обычно хватает одного сервера на 8 GPU.
Что выбрать под задачу
| Задача | Что брать | Почему |
|---|---|---|
| Эксперименты, прототипы, небольшие модели | 1 карта PCIe | Проще и дешевле, связь между GPU не нужна |
| Инференс модели, которая помещается в 1–2 GPU | PCIe или NVL | Решают объём и скорость памяти; у H100 NVL памяти больше, чем у SXM |
| Дообучение LoRA/QLoRA моделей до 13B | 1–2 карты PCIe или NVL | Объём памяти важнее связи между картами |
| Полное дообучение и обучение на 4–8 GPU | SXM на HGX, 8 GPU с NVLink | Карты постоянно обмениваются данными, PCIe станет узким местом |
| Инференс 70B+ с длинным контекстом и многими пользователями | SXM на HGX или NVL с мостами | Модель делится между картами, нужна быстрая связь |
Сколько памяти нужно вашей модели, считаем в статье «Сколько видеопамяти нужно для LLM». Какую модель GPU выбрать, если вы колеблетесь между поколениями, — в материале «H100, A100 или H200: что выбрать».
Что спросить у поставщика перед арендой
Одно и то же название «сервер с H200» может означать восемь SXM на HGX или две карты NVL в обычном корпусе. Задайте шесть вопросов до оплаты.
- Форм-фактор. SXM, PCIe или NVL? Ответ должен быть в предложении письменно.
- Число GPU в сервере. Один сервер на 8 GPU и четыре сервера по 2 GPU — разные вещи для обучения.
- Связь между GPU. NVLink через NVSwitch, мосты NVLink на 2 или 4 карты или только PCIe.
- Память на карту. 80 или 94 ГБ у H100, 40 или 80 ГБ у A100 — это разные карты.
- Мощность и охлаждение. Работает ли карта на полной мощности (для SXM — до 700 Вт у H100 и H200) или ограничена.
- Срок запуска и условия оплаты. Когда сервер будет готов и что оплачивается заранее.
В Ampuna форм-фактор и связь между GPU указываем в подборе до оплаты: на заявку присылаем 2–3 варианта, у каждого — стоимость часа и месяца. Флагманы H200, B200 и B300 — до 8 GPU с NVLink в одном сервере, запуск до 3 рабочих дней после оплаты. Все модели и конфигурации до 8 GPU — на странице аренды GPU-серверов.
8 × NVIDIA H200Hopper · 141 ГБ HBM3e · Россиядо 8 GPU с NVLink в одном сервереот 5 040 ₽/ч≈ 3 679 200 ₽/месОткрыть H200 →NVIDIA H100Hopper · 80 ГБ · Россияот 383 ₽/ч≈ 279 590 ₽/месОткрыть H100 →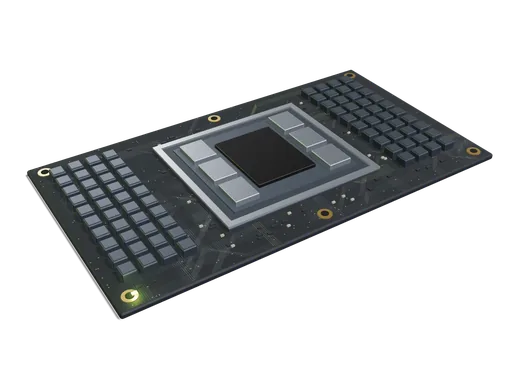
Вопросы и ответы
Чем SXM отличается от PCIe простыми словами?
SXM — модуль, который ставится на плату сервера и связан с соседними GPU по NVLink (900 ГБ/с у H100 и H200). PCIe — обычная карта в слот, связь с соседями идёт через шину PCIe (128 ГБ/с у Gen5) или через мосты NVLink на 2–4 карты. SXM нужен для обучения на многих GPU, PCIe хватает для инференса и работы на одной карте.
Что такое NVL у H100 и H200 — это отдельная карта?
Это PCIe-версия той же модели, рассчитанная на мосты NVLink. У H100 NVL 94 ГБ памяти против 80 ГБ у H100 SXM, но связь медленнее — 600 ГБ/с. У H200 NVL память та же, что у SXM (141 ГБ), мосты объединяют 2 или 4 карты, мощность до 600 Вт вместо 700 Вт.
HGX и DGX — одно и то же?
Нет. HGX — плата NVIDIA на 4 или 8 GPU SXM, на ней разные производители собирают свои серверы. DGX — сервер, который на той же основе собирает сама NVIDIA. GPU и NVLink у них одинаковые, отличаются процессоры, память, диски и сеть.
Подойдёт ли PCIe для обучения LLM на нескольких GPU?
Для двух карт с мостом NVLink — да. Для обучения на 4–8 GPU берите SXM: при распределённом обучении карты постоянно обмениваются данными, и разница между 900 ГБ/с NVLink и 128 ГБ/с PCIe напрямую превращается в часы ожидания.
Влияет ли форм-фактор на цену аренды?
Да: сервер на 8 GPU SXM с NVLink стоит дороже, чем набор PCIe-карт той же модели, потому что дороже сама платформа. Цены «от» за сервер с 1, 2, 4 и 8 GPU — на страницах моделей, например H200.
